搜索到
31
篇与
的结果
-
 短链接技术解析:链接的简化之道 前言大家在短信中是不是经常看到下面的短连接,简短易记:看到这个时你是不是也想把你手里长长的链接变换为这种简单的链接呢?这篇文章我们从短链接起源、短链原理、短链算法、应用场景几个方面从 0 到 1 实现一个短链接服务。起源短连接的发展可以追溯到互联网初期,当时用户在分享长URL时面临繁琐和不便。为了解决这一问题,短连接服务应运而生。最早的服务如TinyURL和http://bit.ly为用户提供了将长URL转换为短连接的便捷方式,成为了这一概念的奠基石。简而言之就是把任何长度的链接压缩成一个短链接,例如 http://t.cn/Ex4V08E 就是 https://www.toolsdaquan.com 的短链接。除了有微博短链接外,国内出名的还有百度短链接(dwz.cn),腾讯短链接(url.cn)等,国外有谷歌短链接(goo.gl),GitHub 短链接(git.io)等。短域名的解析过程短域名的解析过程包括以下步骤:DNS解析:当用户输入短域名访问网页时,首先需要进行 DNS 解析,将短域名解析为对应的 IP 地址。重定向技术:根据短域名所对应的长链接,服务器将发起一个重定向请求,将用户引导至原始的长链接地址。在重定向过程中,常用的状态码有 301 和 302,其中 301 表示永久重定向,而 302 表示临时重定向。通过以上步骤,短域名的工作原理得以实现,用户可以通过简洁的短域名访问到原始的长链接地址,实现了链接的简化和分享的便利性。原文链接:https://blog.csdn.net/fudaihb/article/details/138227442实现原理短链接服务包含两个部分:短链接生成和通过短链接访问原链接,主要流程如下:## 短链接生成 - 使用哈希算法、自增计数等将长URL映射到短标识符,并且短标识符应该足够短以便于记忆和传播。 ## 通过短链接访问原链接 - 一般使用 HTTP重定向的方式。当用户访问短连接时,服务器通过HTTP重定向将其引导至原始URL。1、客户端将短链接服务器传给短链接服务器,服务器根据Hash、自增等方式生成短链接返回客户端。2、客户端使用短链接进行请求,短链接服务器接受到请求后查询到对应的长链接并返回302让客户端重定向到原链接进行访问。常见短链接生成算法哈希算法使用哈希函数对长URL进行哈希运算,得到固定长度的哈希值,然后将哈希值截取为短标识符。常用的哈希函数有MD5、SHA-1、SHA-256等。这种方法的优势在于生成的标识符是固定长度的,且具有较好的均匀性,但哈希算法是确定性的,相同的输入始终产生相同的输出,这使得短链接相对可预测且不易记忆。import hashlib def generate_short_url(original_url): hash_object = hashlib.md5(original_url.encode()) short_code = hash_object.hexdigest()[:8] # 截取前8位作为短标识符 return short_code自增计数使用一个自增的计数器作为短标识符。每次生成短连接时,计数器加一,将其转换为适当进制的字符串作为短标识符。这种方法简单直观,但可能存在预测性问题,容易伪造。class ShortURLGenerator: def __init__(self): self.counter = 0 def generate_short_url(self): short_code = base62_encode(self.counter) # 假设使用62进制 self.counter += 1 return short_code随机生成生成一个随机字符串作为短标识符。这种方法简单且不易被预测,但可能导致短标识符的冲突。import random import string def generate_short_url(): short_code = ''.join(random.choices(string.ascii_letters + string.digits, k=6)) return short_code基于关键字的生成使用关键字或自定义标识符作为短标识符,例如使用文章标题、关键词的缩写等,使短链接更具易记性,但可能导致短标识符的冲突。def generate_short_url_from_keyword(keyword): # 简化处理,可以使用更复杂的映射关系 return base62_encode(hash(keyword))上述是几种常见的短链接生成方式,大家可以根据自己的的场景选择合适的方案。短链接的作用字符空间节省短链接通过将长URL转换为短标识符,大大减少了字符空间的占用。这对于在字符数受限的平台,如短信、二维码等,是非常重要的。美化和简化短链接提供了更美观和易读的方式来分享链接。长URL通常包含大量的字符和参数,短链接使得链接更为整洁,提高了用户体验。个性化定制一些短链接服务提供了自定义短链接的功能,用户可以根据需要为链接添加个性化标识符,使链接更具个性。实现一个简单的短链接服务以下是一个基于 Python 的简单示例,使用 MD5 哈希算法来生成短标识符的短连接服务:import hashlib from flask import Flask, request, redirect app = Flask(__name__) url_mapping = {} def generate_short_url(original_url): hash_object = hashlib.md5(original_url.encode()) short_code = hash_object.hexdigest()[:8] # 截取前8位作为短标识符 return short_code @app.route('/shorten', methods=['POST']) def shorten_url(): data = request.get_json() original_url = data.get('url') if not original_url: return 'Invalid request', 400 short_code = generate_short_url(original_url) short_url = f"http://your-short-domain/{short_code}" url_mapping[short_code] = original_url return {'short_url': short_url} @app.route('/<short_code>') def redirect_to_original_url(short_code): original_url = url_mapping.get(short_code) if original_url: return redirect(original_url, code=302) else: return 'URL not found', 404 if __name__ == '__main__': app.run(debug=True) 示例中: /shorten 路由用于接收 POST 请求,生成短连接并返回短连接的 JSON 响应。 /redirect/<short_code> 路由用于接收短连接请求,根据短标识符重定向到原始URL。zhuanlan.zhihu.com/p/673800947
-
选择 podman 的理由, 以及它和 Kubernetes , Docker 的区别 podman 是什么官方网站: podman.io官方自己的介绍: https://podman.io/whatis.html名称 podman ,官方说明是 Pod Manager , 所以它不仅可以管理 OCI 容器,还可以管理 pod , 这也是和 docker 的最大差别吧.和 kubernetes 的区别kubernetes(k8s) 是目前最流行的容器编排工具, 集群管理工具, 生态很完善, 也很"重", pod 的概念就来自 k8s , 虽然 podman 也是管理 pod, 但是远远不及 k8s 的编排功能, 同时 podman 也没有集群管理功能,如果需要管理集群, 需要第三方工具完成.所以 podman 定位也不是编排和集群管理工具, 紧紧是一个 pod 和容器的管理工具. 所以不是一个级别的东西, 这里不做太多的比较.和 docker 的区别如果仅仅从 docker 和 podman 两个命令提供的功能来讲,它们功能交集很大, podman 官方甚至推荐 alias docker=podman 来过渡.docker 文档更齐全, podman 可以借用一下 docker 的文档docker 生态更加完善, podman 一时半会赶不上,但是如果你只是去跑容器, 那这是一样的docker 有 docker-compose, podman 早期没有对应工具,后面也出了 podman-compose, 但是这个功能是否必须? 值得考虑,因为 podman 支持 pod 管理.docker 有 machine , 让 windows 和 mac 支持 linux 容器, podman 也支持,而且已经比较完善.docker 有 docker-desktop , podman-desktop 目前还比较简单.docker 支持 rest api , podman 也支持 rest api, 这使得开发生态工具会比较简单.docker 有 swarm 支持集群部署, podman 没有对应工具, 不过支持 remote , 调用远程机器上的 podman service 执行对应的功能 , 这样能满足很多轻量化的场景.k8s 之前支持使用 docker-shim 和 docker 集成, 不过新版本也放弃这一层, 直接通过 CRI 调用 contained , podman 也不支持 CRI. 并且也没有什么计划.docker 商业/开源并行, podman 只有开源版本, 目前没有哪家公司提供商业支持(不清楚 redhat 有没有对应的服务,可能集成在订阅里面了).为什么选 podman上面讲了不少 docker 比 podman 有优势的方面, 这里开始讲 podman 的另外的东西, 这也是我选择 podman 主要原因.先罗列一下 podman 适合的场景没有很强的集群管理需求(或者说,已经有 overlay network 方案, podman 也是适用的)仅仅为了容器化一些应用团队内部轻量级使用,比如 ci/cd , 开发,测试环境等.喜欢命令行或者脚本运维感兴趣 podman 的生态建设(坑)那么 podman 比 docker 好的方面有哪些呢?更加 rootless , 尽管 docker 也可以 rootless, 但是 podman 设计之初就开始支持没有 daemon , 这使得 podman 在结合 namespace 和 cgroup 一起使用会更加灵活pod , 和 k8s 基本一样的 pod , 一样支持 infra 容器. 这使得一些简单的容器编排 工作, podman 也可以简单实现.systemd service 集成, 由于没有 deamon , podman 通过 generate 子命令, 可以生成 systemd service 配置, 来管理容器和 pod 的作为服务启动.k8s 关联, podman 可以生成 kubectl 的 yaml 配置文件, 也通过 podman play kube 来运行 k8s 的配置, 也可以作为 k8s 的一个过渡吧, 而且 podman 也没有去实现 CRI 的计划, 这应该也是官方的态度, 不会参和到 k8s 生态中, 保持自己的轻量化工具的定位吧.remote , podman 通过 ssh 隧道或者 tcp 端口, 可以连接到远程机器上的 podman service, 从而实现远程机器上的容器和 pod 管理.所以 podman 提供了一些轻量化而又灵活的功能特性,满足容器化,以及小批量服务器的场景.https://zhuanlan.zhihu.com/p/506265757
-
Docker与虚拟机的区别和对比 从自己的博客园保存 2020-02-03 17:59 Docker与虚拟机的区别和对比由于Docker相比于虚拟机,在诸多方面有着的明显的优势,所以仅仅数年时间,就完成了从诞生,到兴起,再到主流的蜕变,这无疑也是对其在软件开发中卓越贡献的肯定。以下为二者区别的概述:操作系统方面与虚拟机不同,Docker不需要在宿主机的系统之上再运行新的系统,虚拟机会根据需要加载不同的系统,这些功能完备的系统大小往往高达数个GB,而Docker则是微型的Linux系统,其没有硬件的虚拟化资源,大小仅为百兆,在运行时与宿主机共享OS,因此启动速度达到秒级,而虚拟机则为分钟级。储存大小方面Docker容器的镜像很小,非常方便存储和传输,运维工程师可以分分中完成下载和运行,而对于虚拟机来说,它的镜像,如vmdk、vdi等,就显得十分庞大,往往在10G以上,传输和存储十分不便。运行性能方面无论是在服务器和本地PC上运行,Docker几乎没有性能的损失,不浪费原本就很珍贵的资源,所以即使是“小霸王”,也能跑的起来。而虚拟机则需要消耗大量的、额外的CPU和内存资源,在打开idea的情况下,再跑一到两个Linux,一般的机器肯定是可以体验到如集成显卡打单机一般的酸爽了。移植性方面Docker容器轻便、灵活、适应于Linux,而虚拟机相对笨重,与虚拟化技术的耦合度非常高,因此移植性相对较差。部署速度Docker的部署往往在按下回车的谈笑之间,而虚拟机的部署则需要再加上一支烟。功能方向方面Docker致力于给软件开发者带来便捷,可以很大程度上促进DevOops模式的发展。而相对笨重的虚拟机则专注于为硬件运维者提供服务。(在这个软件爆发的时代,硬件的发展很大程度上被忽略,软件有高工资,有大量的新晋人才,一个大牛带着个位数人员团队干个几个月就可以拿到投资,闪亮登场。而硬件技术发展相对需要付出巨大的成本,难见成效,因而关注较少,往往只有大佬级公司才会有资金和精力去研究硬件。而硬件,才是信息时代的根基啊。)————————————————版权声明:本文为CSDN博主「达希希」的原创文章,遵循 CC 4.0 BY 版权协议,转载请附上原文出处链接及本声明。原文链接:https://blog.csdn.net/weixin_43838898/article/details/100058671
-
浅谈芯片的bringup 一,浅谈芯片研发谈到芯片,中美贸易战的中兴事件引发了社会对芯片行业的大量关注,本文不做累述芯片行业现状、痛点,只给大家展现芯片行业纯技术的某一面。先以芯片研发流程开篇,下图为个人理解的芯片研发流程图。图1 芯片研发流程图任何产品都有面向群体,芯片也不例外,面向手机、相机等消费类电子产品,面向机器人、行业自动化等工控类设备,目前主流芯片偏向消费类电子。芯片的面向最终都是转换成规格和需求,需求方或领导层先提要求,架构工程师、项目经理、项目管理、各技术组组长坐在一起讨论拍板出我们芯片所需要的规格list和需求list,这是第一步。接着,项目管理、经理负责资源组和人员的调配。技术方面,架构师是重点,对需求和规格list进行细化到具体,搭建架构,架构的分析与建模,仿真出可行性,比如整个集成芯片划分为几个模块、CPU选型、主频、总线划分等。如果涉及到高层次算法,需要完成芯片中数字部分的高层次算法,为硬件提供一个正确的软件功能模型,通过大量的高层次仿真和调试,为RTL实现提供总体性的设计指导。芯片从功能上来看,是由各个IP综合集成出来的。国内多数集成芯片都是采购IP,自研IP多数为小IP,一般ARM、DSP、普罗米修斯等CPU类IP多为采购,当然也不乏大公司自研DSP、超级CPU等,DDR PHY、SD PHY等高速接口IP也多为采购,国内算法能力很强,目前ISP、GPU、CNN、CODEC等都有大公司在自研。集成和实现都是RTL阶段,CRG(Clock Reset Gate)就是在这个阶段设计的,另外系统、总线、安全等相关控制也是RTL集成和实现的重点。集成将所有IP集合,安排和分配好脉搏、功能信号。实现靠近实际,RTL实现之后就是软件人员所看到的寄存器手册。集成阶段非常重要的是时序,尤其是异步时序,所以需要验证。验证由根据平台划分为EDA验证、FPGA验证、ZEBU验证等。嵌入式接触比较多的是FPGA和ZEBU验证。EDA验证是模拟的环境上验证的,但其最接近最后的AISC,但仿真毕竟是仿真,离实际差异还是很大;FPGA只能做前端验证,它最真实,也是验证速度最快的,但其频率的限制、模拟器件无法模拟,导致很多功能并不能验证的很完整,CRG 、power control、pinmux根本无法验证,,各类高速接口的PHY无法真实测试,FPGA的CRG一般尽量按比例集成;ZEBU平台也是基于FPGA上集成的,但其可完全模拟出时序关系,不过也存在FPGA的其它通病,而且其验证速度比EDA更慢,跑一个复杂点的验证用例可能需要一天。各大仿真或验证平台各有优缺点,但实际的芯片并没有验证环境那么理想,有corner、生产工艺、功耗散热、DDR稳定性等各种因素,导致最后的芯片问题百出。需要注意,验证并不是固定顺序的,任何一个阶段都需要。前面陈述的都属于前端,国内后端不甚重视,总体上按顺序有数据整理提供、布图、布局、preCTS(setup优化)、CTS(clock tree setup)、postCTS(进一步优化)、布线、post布线、ECO(进入此过程再无法修改数据)、finish、signoff(检查和验证)、tapeout(设计数据传递给制造方)。最后就是流片生产,多数在台积电、台联电,嵌入式在此过程需要准备回片bring up的代码,重点在CRG、power、高速IP等仿真无法覆盖完整的代码。然后等芯片回来,芯片一旦回来,就是嵌入式的大头戏,回片bring up阶段,所有人都在关注着这最后一炮的成功与否,芯片就是一锤子买卖,题外话的说,芯片的回片现场非常类似robocon比赛现场。以下以常用的ARM cortex-A为主的SOC系列芯片bring up为例。本文纯手敲,如有出入,自行参考。二,整体bring up流程回片bring up工作非常关键,但芯片是否如意并不是嵌入式能决定的,虽然前期有负责FPGA、ZEBU验证起到验证作用,但芯片行业的核心不在嵌入式,我们只是检验大家成果的一面镜子。但换个方向思考,嵌入式是处于最底层的软件,对芯片负责,如果过了嵌入式把问题释放出去,那就会收到无数的投诉、黑评等。回片工作流程如图2。图2 芯片回片bring up流程回片工作基本上所有IP的冒烟都需要两个前提,coresight(debug/trace)和DDR。图2中还少了SOC的基本功能冒烟实现这个前提,比如CRG、power manager、安全等,由于其牵涉到每一模块,故不加入图中。DDR冒烟非常关键,通常三大巨头公司海力士、镁光和三星都需要测试,开始时有bypass training方案,高频方案等,与产品实际性能需求有关,后面为了稳定性还得进行不同corner芯片、高低温下的压力测试。DDR之后就可以并行工作了,此时需要根据芯片应用场景进行对应IP功能冒烟,图2提供了多种场景的bring up实现,最基础的kernel的启动、sensor-显示通路、图像识别和处理、编解码等。本文重心在系统的bring up介绍,不展开场景介绍。三,系统的bring up系统的启动流程是bootrom->bootloader->kernel->filesystem,具体可参考图3。图3 某芯片启动流程详解图1,bootrombootrom是系统之始,也就是第一份代码,例如BIOS就是windows的bootrom。大部分嵌入式开发者或者谷歌BSP(Board Support Package)一般最多深究到bootloader,忽略bootrom也是因为它是随着生产固化的,与芯片本身息息相关,硬件工程师关注比较多,软件不可更改,也没必要修改。但如果想对芯片真正了解,必须对bootrom的代码甚为了解。bootrom里面做了以下几个事:(1)主CPU boot,一般bootrom只启动单核,并配置处于次低频态;(2)切入slow或normal模式;(3)efuse相关位检测;(4)如果涉及到,调整芯片的安全相关属性;(5)如果涉及到,将必须的电压打开;(6)配置debug串口,提供开发者调试;(7)检测是否非默认引导方式,并引导,有flash/emmc、USB fastboot、ETH等引导;(8)根据所选方式引导,跳转到RAM起始地址。值得注意的是既然有多种引导方式,那就可以用以太网、USB甚至串口传输boot程序给芯片,让其运行自己想要的非主线分支程序,比如fastboot功能的实现、安全属性强行修改等。当然,芯片安全问题不用担心,efuse里会有加密信息,bootrom会去校验你的FW,俗称签名。2,bootloaderbootloader非常关键,是底层软件大展身手的地方。bootloader最终目的是启动内核,至于内核是linux、rtos或者其它OS都可以。bootloader也并不止uboot,还有little kernel、redboot、armboot等,甚至可以自己手写,个人接触比较多的是uboot和little kernel。uboot适应性高,对成熟芯片可以做到是快速上板,对新开发芯片能做到参考作用,但其内容繁琐,全新芯片开发难度比little kernel更大。此处以更为通用的uboot展开,讲述bootloader具体干了什么事情。Uboot,即universal-bootloader,分为两个阶段,SPL阶段和uboot第二阶段,划分两个阶段是因为片内RAM的价格高昂,且大小一般都只有几十上百K。uboot为了适应各种平台适应各种OS,越到后面版本越来越庞大,为此设计者将uboot一分为二,将初始化flash/emmc并把存储的程序搬运到片外RAM的小uboot称为SPL,将启动内核的大uboot放入片外RAM(一般是DDR,即SDRAM),采取图4流程启动OS。Uboot也支持单阶段启动或者直接flash启动,但都非常少用,个人曾强行简化uboot到100K,但把uboot很多模块给去除了,比如交互界面、哈希表,导致代码完全像重写,后面弃用不了了之。图4 uboot启动流程图4是常见的一种uboot流程,由于是两片内存空间,两个阶段都需要做系统的初始化工作,异常向量表、堆栈、BSS、data、heap、代码段,值得重视的是SPL在底层初始化阶段是无BSS、data、heap段的。SPL阶段的流程很简单:(1)ARM的boot,SP、exception设置,关闭MMU、Icache、Dcache;(2)初始化CRG,电压、频点和工作模式初始化;(3)初始化debug串口,初始化FLASH,初始化片外RAM;(4)如果有需要,release其它核或其他CPU,如DSP、cortex-M系列ARM等;(5)如果有安全需要,boot TrustZone OS;(6)Relocate堆栈、GB等到第二阶段uboot;(7)直接跳转到片外RAM执行第二阶段。第二阶段就是uboot真正起作用的阶段了,其主要流程见图5。uboot的核心在于boot起各类kernel,但它本身不止于此,它还有改写flash内容,对内存映射区域改写,修改启动环境参数等功能,实现都在图5的最后console界面里,俨然是一个小型的裸机交互系统。图5 第二阶段uboot流程这里只浅谈下核心部分,也就是起kernel功能。uboot启动的内核为uImage或者zImage,也可以是压缩包,内核格式一般是由两部分组成:真正的内核和内核头部组成,头部中包括内核中的一些信息,比如内核的种类,加载地址,入口地址。以linux为例:uboot在接收到启动命令后,要做的主要是,读取内核头部信息,移动内核到合适的加载地址,启动内核,执行do_bootm_linux。do_bootm_linux主要做的为,设置启动参数,在特定的地址,保存启动参数arg,传递设备树dtb,以及根文件系统rootfs信息,解压kernel并放置到指定片外RAM位置,跳到入口地址,启动内核。3,Kernel大部分嵌入式都是在kernel之上做着辛勤的工作,调用各种标准的写驱动接口,基于各种驱动做开发,标准的代码接口,比如linux的io control、debugfs、sysfs、用户态程序,再如rtos的任务创建挂起、信号量、邮箱等等。本节非常浅面的谈谈kernel的bring up过程。以linux为例,主要流程如图6。图6 linux启动流程首先,从bootloader接管控制权后,首先读入根目录下的内核文件,该过程对设备树进行了扫描注册。内核文件加载以后,就开始运行第一个程序linuxrc或init,它的作用是初始化系统环境,这个进程的PID为1,后面称之为init进程。这时候,许多程序需要开机启动,这些在Windows叫做“服务”(service),在Linux就叫做"守护进程"(daemon),init进程的一大任务,就是去运行这些开机启动的程序。但是,不同的场合需要启动不同的程序,linux允许为不同的场合,分配不同的开机启动程序,这就叫做“运行级别”(runlevel)。接着,每个运行级别的运行程序在/etc目录下面,都有一个对应的子目录rc*.d,选择后通过init.d链接启动。这时,开机启动程序加载完毕,然后要让用户登录,有三种登陆方式:命令行登录、ssh登录和图形界面登录,为了方便一般用ssh登录或者直接默认登录某user用户来方便开发者调试。至此,Linux的启动过程就算结束了。4,filesystem文件系统的格式极其多,每种格式都有独立的生成标准,最常用的格式,ext4、fat32,一个是linux常用,一个是windows常用,占了大片江山。所有格式文件系统说白了都是对操作系统用于在存储介质上组织文件的方法。存储设备不管是易失的RAM,还是不丢失的ROM,只要可以提供标准的initialization、read、write,都可以对某个区域或者整个区域进行格式化。比较常见的文件系统格式化设备有SD卡、硬盘、EMMC等ROM设备,一般不用于RAM中。rtos一般是等系统起来后通过进程去管理文件系统,不会用到RAM文件系统。但linux不同,在boot loader 配置了某些参数的情况下(这也是常规做法),它的启动不会一来就加载ROM的文件系统,这就涉及到一个中间系统,称为initrd、ramdisk或者initramfs,后面简称initrd。而最后我们敲shell命令的界面所在文件系统称作rootfs,也即根文件系统。以下浅要介绍linux启动所用的到文件系统。在linux内核启动前,boot loader 会将存储介质中的initrd文件加载到片外RAM,内核启动时会在访问真正的根文件系统前先访问该内存中的initrd 文件系统。内核启动被分成了两个阶段,第一阶段先执行initrd 文件系统中的某个初始化文件,完成加载驱动模块等任务,第二阶段才会执行真正的根文件系统(rootfs)中的init 进程。linux是基于unix的系统,unix的设计之初有一哲学核心思想,即“一切皆文件”,在linux上的体现就是rootfs。简单的说,rootfs是一个带有linux整套内核体系结构和硬件设备注册的文件系统,可以看到设备节点,用户进程,debug信息等。相信linux驱动工程师了如指掌。不管是rootfs还是initrd,其实都是一样的文件形式,可以做成同源。rootfs的生成比较有名的工具叫做busybox,busybox自带有许多设备操作和shell的库。在这介绍两个开源代码,一个叫做buildroot,一个叫做yocto,都是基于busybox工具上的rootfs生成项目,都具备可视化可裁剪定制界面,库自选,busybox还带有许多boot kernel相关开源代码,同样initrd也可通过它们获得。至此,芯片的系统bring up结束。接下来就是各模块的驱动开发,和各种业务场景的实现了。版权声明:本文来源网络,免费传达知识,版权归原作者所有。如涉及作品版权问题,请联系我进行删除。https://www.eet-china.com/mp/a350381.html
-
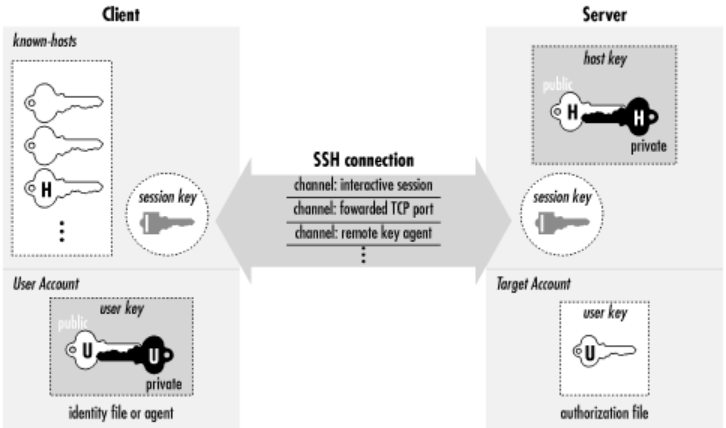
SSH协议详解 作为程序员,一定不会没有用过ssh吧。当我们需要远程登录到服务器上进行操作的时候,一般就会用ssh。ssh是secure shell的简称,它相对于早起的telnet和rsh的明文传输,提供了加密、校验和压缩,使得我们可以很安全的远程操作, 而不用担心信息泄露(当然不是绝对的,加密总有可能被破解,只是比起明文来说那是强了不少)。本文会详细的讲解SSH协议是怎么定义的,以及他是怎么实现安全的加密。几个基本概念在介绍ssh协议之前,有几个涉及到的基本概念首先需要介绍,它们对于理解ssh协议本身有非常重要和关键的作用。加密加密的意思是将一段数据经过处理之后,输出为一段外人无法或者很难破译的数据,除了指定的人可以解密之外。 一般来说,加密的输入还会有一个key,这个key作为加密的参数, 而在解密的时候也会用一个相关联(有可能是相同)的key作为输入。粗略来说是下面的流程:加密方encrypted_data = encrypt(raw_data, key)解密方raw_data = decrypt(encrypted_data, key1)目前主流的加密算法一般分为下面两类:1.私钥(secret key)加密,也称为对称加密2.公钥(public key)加密私钥加密所谓的私钥加密,是说加密方和解密方用的都是同一个key,这个key对于加密方和解密方来说是保密的,第三方是不能知道的。在第三方不知道私钥的情况下,是很难将加密的数据解密的。一般来说是加密方先产生私钥,然后通过一个安全的途径来告知解密方这个私钥。公钥加密公钥加密,是说解密的一方首先生成一对密钥,一个私钥一个公钥,私钥不会泄漏出去,而公钥则是可以任意的对外发布的。用公钥进行加密的数据,只能用私钥才能解密。加密方首先从解密方获取公钥,然后利用这个公钥进行加密,把数据发送给解密方。解密方利用私钥进行解密。如果解密的数据在传输的过程中被第三方截获,也不用担心,因为第三方没有私钥,没有办法进行解密。公钥加密的问题还包括获取了公钥之后,加密方如何保证公钥来自于确定的一方,而不是某个冒充的机器。假设公钥不是来自我们信任的机器,那么就算我们用公钥加密也没有用,因为加密之后的数据是发送给了冒充的机器,该机器就可以利用它产生的私钥进行解密了。所以公钥加密里面比较重要的一步是身份认证。需要说明一下,一般的私钥加密都会比公钥加密快,所以大数据量的加密一般都会使用私钥加密,而公钥加密会作为身份验证和交换私钥的一个手段。数据一致性/完整性数据一致性说得是如何保证一段数据在传输的过程中没有遗漏、破坏或者修改过。一般来说,目前流行的做法是对数据进行hash,得到的hash值和数据一起传输,然后在收到数据的时候也对数据进行hash,将得到的hash值和传输过来的hash值进行比对,如果是不一样的,说明数据已经被修改过;如果是一样的,则说明极有可能是完整的。目前流行的hash算法有MD5和SHA-1算法。身份验证身份验证说的是,判断一个人或者机器是不是就是你想要联系的。也就是说如果A想要和B通信,一般来说开始的时候会交换一些数据,A怎么可以判断发送回来的数据就真的是B发送的呢?现实中有很多方法可以假冒一个机器。在SSH里面,这主要是通过公钥来完成的。首先客户端会有一个公钥列表,保存的是它信任的机器上面的公钥。在开始SSH连接之后,服务器会发送过来一个公钥,然后客户端就会进行查找,如果这个公钥在这个列表里面,就说明这个机器是真的服务器。当然实际的情况会复杂一些。实际上服务器不是真的发送公钥过来,因为这很容易被第三方盗取。这个在下面会详细的讲述。SSH2协议概况理解一个协议最好是从他的大概信息交流流程来了解。这个在《SSH: The Secure》里面有很详细的说明,我从中摘取了几个主要的图来说明一下。首先是一个主要的脉络图:可以看到,里面有几个关键的key:1.session key: 这个是用来作为secret key加密用的一个key,同时也作为每个ssh连接的标识ID。2.host key: 这个是用来作为server的身份验证用的。3.known-hosts: 这个是存在客户端的一个可信server的public key列表。4.user key: 这个是用来作为client的身份验证用的。当server和client交换了session key之后,所有的数据都会使用这个session来进行私钥加密。上面的图是一个很粗略的描述,下面这个图是对SSH2协议的一个详细的描述:上面这幅图大致的说明了SSH2协议的全景。首先SSH2协议分为3个子协议,分别是SSH-TRANS, SSH-AUTH和SSH-CONN。其中SSH-TRANS是传输协议,定义了传输的包和加密通道,其他两个协议是建立在这个协议之上的。SSH-AUTH是SSH里面用于验证客户端身份的协议。我们在用ssh命令输入密码的那一步实际上就是在这个阶段。可以看到的是,虽然传输的是用户名和密码,但是由于这个协议建立在SSH-TRANS之上,所以内容都是加密的,可以放心的传输。而SSH-CONN是真正的应用协议。在这里可以定义各种不同的协议,其中我们经常使用的scp、sftp还有正常的remote shell都是定义在这里的一种协议实现。这里的各种应用协议都要首先经过SSH-AUTH的验证之后才可以使用。这个三个协议之间的关系可以用下面这幅图来说明:其中SSH-TRANS是基本的协议,SSH-AUTH和SSH-CONN都是通过这个协议来实现安全加密的。虽然在时序上,SSH-CONN发生在SSH-AUTH之后,但是SSH-CONN并不依赖于SSH-AUTH。SSH ProtocolSSH-TRANS首先介绍一下SSH-TRANS的基本结构。在客户端连接上SSH服务器之后,会进行下面协议通信:客户端和服务端都向对方发送一个ssh版本字符串。字符串的格式如下:SSH-protoversion-softwareversion SP comments CR LF其中comment是可选的。 一般来说,目前用的ssh服务器和客户端一般都是支持SSH2,所以一个开始的version string一般就像下面这样:SSH-2.0-OpenSSH CR LF接下来的通信都用SSH自身定义的一个Binary Packet Protocol进行通信。这个Binary Packet Protocol其实就是将所有的用户数据都加上长度头,然后再进行加密。一个Packet的定义如下:uint32 packet_lengthbyte padding_lengthbyte[n1] payload; n1 = packet_length - padding_length - 1byte[n2] random padding; n2 = padding_lengthbyte[m] mac (Message Authentication Code - MAC); m = mac_length实际上所有的数据都放在payload里面。最后的mac是用来给数据计算校验码用的。在传输完ssh version string之后,客户端和服务端会开始进行key exchange,简称kex。Kex是用来让客户端和服务器生成本次通信的密钥和session ID的。 在kex之后,服务器和客户端都有一个key和hash,而私钥加密用的secret key就是通过这两个值来生成的。 具体的算法这里就不阐述了,可以去看SSH-TRANS的RFC[2]。在kex的最后一步,服务器会给客户端发送他自己的public key。 而客户端会通过在自己的known_hosts里面查找这个public key来验证服务器的身份。 至此,服务器和客户端都用来secret key,所以接下来所以数据都会进行加密,而不用担心信息泄露。 在kex之后,客户端就可以开始进行SSH-AUTH,也就是叫服务器验证自己的身份。SSH-AUTH在客户端的身份认证中,有3种预先定义好的方法可以用。1.public key2.password3.hostbased其中前两种是我们平常最常用的:password就是一般的密码验证,而public key就是一般的无密码验证。 当服务器成功的验证了客户端的身份之后,就会开始客户端请求的服务(service)了。 需要注意的是,服务器的验证方式并不是说3种方式任选其一,而是可以组合的。也就是说,服务器可以要求客户端同时通过Password和public key两种方式的认证。SSH-CONN这个也就是我们最后用到的一个服务的协议定义了。最常用的包括shell, port forwarding,X11 forwarding等等。在SSH-CONN里面最重要的就是Channel的机制了。在SSH-CONN里面,和服务器的通信基本上都是通过建立channel来通信的。 多个channel共享同一个ssh session。SSH协议自身定义如何负责多个channel之间消息的分发。 对于使用者来说只需要开多个channel就可以了。 比如说普通在ssh的客户端开启port forwarding的时候,就会开启一个shell channel和一个forwarding channel。 这一part对于程序员来说都是比较熟悉的。Library目前看的ssh的库主要有libssh和libssh2。其中的比较可以在这里找到。从接口上来说, libssh2的接口定义比较清晰,不过libssh2只能用于client端的开发,而libssh可以进行server和client端的开发。 而且libssh2的文档比libssh的文档要差些。在做开发的时候文档是一个很关键的因素。References:.SSH: The Secure Shell.SSH-TRANS.SSH-ARCH.SSH-AUTH.SSH-CONN