搜索到
38
篇与
的结果
-
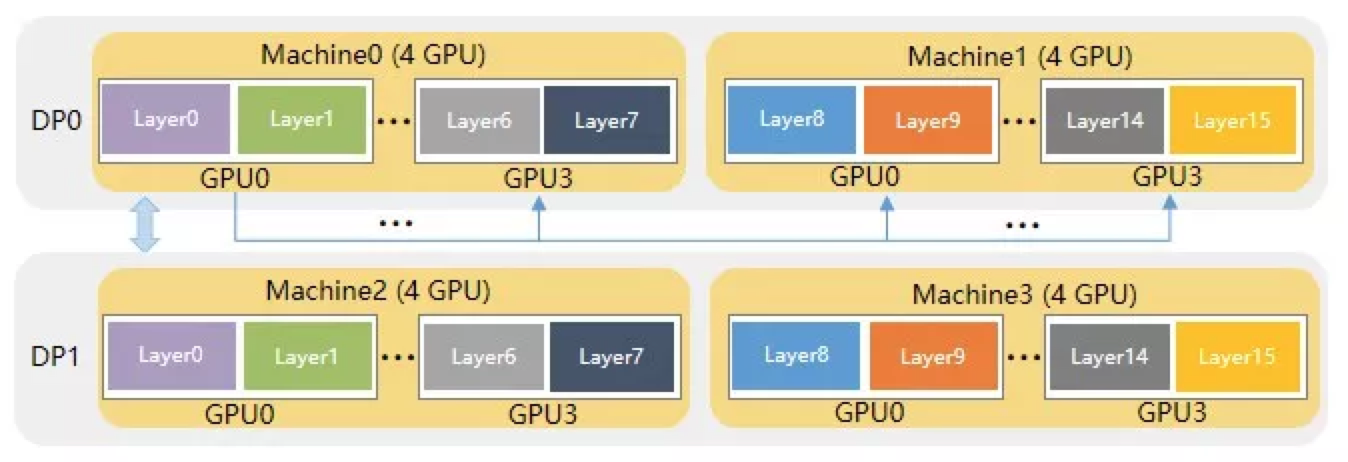
 AI专题三十三:LLM训练:GPU利用率与MFU计算方法 模型算力利用率(Model FLOPs Utilization, MFU)和硬件算力利用率(Hardware FLOPs Utilization, HFU)是评估某一模型实现对芯片计算性能利用情况的常用指标。模型算力利用率是指:模型一次前反向计算消耗的矩阵算力与机器算力的比值硬件算力利用率是指:考虑重计算后,模型一次前反向计算消耗的矩阵算力与机器算力的比值注:FLOPs指浮点运算次数,FLOPS指每秒的浮点运算次数通用transformer模型一次前反向算力计算公式如下,model FLOPs per iteration:上述公式除以 一次迭代时间和机器算力,就是MFU,即MFU = model FLOPs per iteration/(GPU单卡算力卡数一次迭代时间),用公式表达如下transformer 模型的层数为 l隐藏层维度为 ℎ注意力头数为 a词表大小为 V批次大小为 b序列长度为 sGPU单卡的峰值算力 F训练使用GPU的卡数 N训练一次迭代时间 T在模型固定的情况下,减少卡数和一次迭代时间,可以增大MFU。所以减少训练时间就是提高MFU。Iteration: 使用一个Batch数据对模型进行一次参数更新的过程,称为“一次训练”,“一次迭代”如何计算FLOPs有两种方式:根据计算公式和模型结构手动推算借助第三方工具:calflops、ptflops、thop、torchstat、torchsumary、fvcore手动推导FLOPs原则:手动推导模型的FLOPs时只推导前向传播,大部分情况默认模型后向传播的计算量是前向传播的2倍, 总共FLOPs是前向的3倍。(结论出自——https://epochai.org/blog/backward-forward-FLOP-ratio)由于LLM模型参数过大,占用显存过多,有时候为了降低显存在训练采用将中间参数保留在内存里——激活重计算。因此推导LLM训练时FLOPs如果考虑到中间参数的激活重计算的过程,需要计算整体FLOPs需要再加一份前向计算量,即1(前向) + 2(反向)+ 1(激活重计算)= 4 倍 计算量。 (结论出自——https://arxiv.org/pdf/2205.05198.pdf)手动推导模型的FLOPs时,优先推导整个过程计算量占大头部分,通常忽略激活函数、layer normalize,softmax等等部分计算量。参考最简单的计算模型(LLM)FLOPs的方法前向计算量前置对于一般化的 [m,n]×[n,p] 矩阵,GPU 两层循环分别计算行列,因此 次行列运算,共 2mnp 次运算。前向分成3部分标记:transformer 模型的层数为 l隐藏层维度为 ℎ注意力头数为 a词表大小为 v批次大小为 b序列长度为 sAttentionAttention 计算公式涉及 FLOPs 计算的主要是矩阵乘法,加法、乘系数、dropout 计算量较小通常忽略不计。Attention 层的矩阵乘法主要四个,分别是输入算 Q ,K ,V,QK相乘,输出四步。MLPMLP 计算如下详细见 【Transformer 基础系列】手推计算量FLOPS和训练时间理想情况计算量估算当隐藏维度比较大,且远大于序列长度时,我们可以忽略一次项,计算量可以近似为实际情况时间估算上面说的算理想情况:即首要考虑 GPU 前后向时算矩阵运算这个时间大头,而且 h >> s,利用率100%,不考虑更新、通信、切分、其他步骤(加载数据、log等等)。实际情况不可能达到 100%,如果考虑到上述效率,一般要打折扣。折扣系数要看框架,目前比较高效的框架算上通信加载也就0.5 模型大通常来说折扣还会高 ,因为矩阵运算占比变大了。这里 是对应 GPU 的计算能力,K是一次训练每个参数·token需要的浮点运算(K=8 如果用重计算,K=6 如果不用)。Megatron-LM中FLOPs计算Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM https://arxiv.org/pdf/2104.04473.pdfNVIDIA ‡Stanford University ∗Microsoft Research附录 APPENDIX: FLOATING-POINT OPERATIONS在本节中,我们描述了如何计算模型中的浮点运算(FLOPs)数量。我们考虑一个具有 𝑙 个Transformer层、隐藏大小 ℎ、序列长度 𝑠、词汇量 𝑉 和训练批量大小 𝐵 的语言模型。NVIDIA FLOPs计算[论文学习]在大型 Transformer 模型中减少激活重计算附录A FLOPs Calculation对于FLOPs的计算,我们遵循了Narayanan等人的推导[13],只考虑了矩阵乘法(GEMMs),这是浮点运算数量的主要贡献者。参考Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM[论文笔记]Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM最简单的计算模型(LLM)FLOPs的方法训练模型算力的单位:FLOPs、FLOPS、Macs 与 估算模型(FC, CNN, LSTM, Transformers&&LLM)的FLOPs【Transformer 基础系列】手推计算量FLOPS和训练时间FLOP估算脚本 https://github.com/google-research/electra/blob/master/flops_computation.pyThe FLOPs Calculus of Language Model Training“反向传播算法”过程及公式推导昇腾大模型|分布式并行-7——模型算力利用率(MFU)+硬件算力利用率(HFU)序列模型(3)—— LLM的参数量和计算量
-
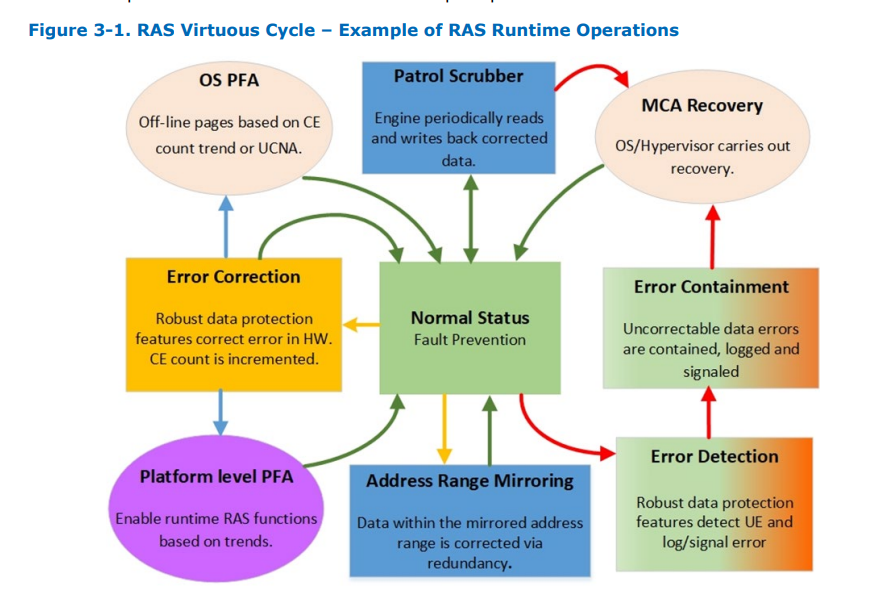
芯片领域中 RAS 的概念及实际技术举例 Reliability, Availability, and Serviceability可靠性(Reliability)系统持续产生正确结果并确保数据完整性的能力,核心是错误检测与纠正。关键技术与原理ECC(Error-Correcting Code)通过冗余数据位检测和纠正内存中的单/多位错误。例如,ECC 内存可修复单比特错误,避免系统崩溃。奇偶校验(Parity)与 CRC(Cyclic Redundancy Check)奇偶校验:通过奇偶位检测单比特错误,但无法纠正。CRC:通过多项式计算生成校验码,检测数据传输中的错误(如网络通信)。错误隔离与标记对不可纠正的错误(如多比特内存故障),系统隔离错误数据并标记,防止错误扩散(例如内核内存错误可触发系统崩溃保护)。SDDC(Single Device Data Correction)内存控制器通过 ECC 技术,即使单个内存芯片完全故障,仍能纠正数据错误(如 Intel 的 x4 SDDC)。内存镜像(Memory Mirroring)全镜像:复制所有内存数据到备用模块,故障时切换(牺牲 50% 容量)。地址范围镜像:仅镜像关键区域(如内核内存),降低成本并保护虚拟化环境中的核心状态。可用性(Availability)系统在故障时保持运行的能力,核心是容错与降级运行。关键技术与原理CPU 自检(BIST, Built-In Self-Test)系统上电时自动检测硬件状态,确保基础组件(如缓存、寄存器)正常,否则阻止启动。UPI 动态链路宽度缩减当高速互连链路(如 Intel UPI)发生 CRC 错误时,自动减半链路宽度(如 16 位 → 8 位),以维持通信功能。内存禁用与映射(DDR5)检测到故障内存单元后,系统在初始化阶段将其标记为禁用(map-out),允许剩余内存正常引导至操作系统。CXL/PCIe 热插拔支持在不关机情况下更换故障设备(如硬盘、GPU),通过冗余链路维持系统运行。PCIe 链路重新训练当链路信号质量下降时,重新协商通信参数(如速率、电压),恢复稳定连接。预测性故障分析结合算法(如机器学习)分析硬件健康状态(如温度、电压),提前触发维护操作(如迁移数据、降频)。无缝固件更新通过双固件分区设计,在运行时更新微码(如 CPU 微码),无需重启系统。可维护性(Serviceability)快速诊断和修复故障的能力,核心是错误日志与访问机制。关键技术与原理错误报告与日志硬件记录错误详细信息(如错误类型、位置),供管理员通过操作系统或管理接口(如 IPMI)查看。超时定时器检测组件响应超时(如 CPU 未收到内存响应),触发错误中断并记录日志,防止系统挂起。带外(OOB)错误收集(如 JTAG)通过独立于操作系统的接口(如 JTAG 调试端口)访问硬件日志,即使系统崩溃也能获取故障信息。带内错误收集(状态寄存器)通过操作系统直接读取硬件寄存器中的错误状态(如 PCIe 设备的配置空间),简化诊断流程。总结可靠性:通过 ECC、镜像等技术确保数据正确性。可用性:通过热插拔、链路恢复等技术最小化停机时间。可维护性:通过日志、OOB 访问等技术加速故障定位。可以观察到,高可靠性和高可维护性会导致高可用性,因为一个不发生故障的系统具有很高的可用性。如果它遇到故障,高可维护性确保系统能够更快地恢复运行,从而提高整体可用性。
-
-
-