
模型算力利用率(Model FLOPs Utilization, MFU)和硬件算力利用率(Hardware FLOPs Utilization, HFU)是评估某一模型实现对芯片计算性能利用情况的常用指标。
模型算力利用率是指:模型一次前反向计算消耗的矩阵算力与机器算力的比值
硬件算力利用率是指:考虑重计算后,模型一次前反向计算消耗的矩阵算力与机器算力的比值
注:FLOPs指浮点运算次数,FLOPS指每秒的浮点运算次数
通用transformer模型一次前反向算力计算公式如下,model FLOPs per iteration: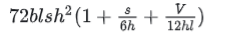
上述公式除以 一次迭代时间和机器算力,就是MFU,即
MFU = model FLOPs per iteration/(GPU单卡算力卡数一次迭代时间),
用公式表达如下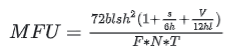
transformer 模型的层数为 l
隐藏层维度为 ℎ
注意力头数为 a
词表大小为 V
批次大小为 b
序列长度为 s
GPU单卡的峰值算力 F
训练使用GPU的卡数 N
训练一次迭代时间 T
在模型固定的情况下,减少卡数和一次迭代时间,可以增大MFU。所以减少训练时间就是提高MFU。
Iteration: 使用一个Batch数据对模型进行一次参数更新的过程,称为“一次训练”,“一次迭代”
如何计算FLOPs
有两种方式:
根据计算公式和模型结构手动推算
借助第三方工具:calflops、ptflops、thop、torchstat、torchsumary、fvcore
手动推导FLOPs原则:
手动推导模型的FLOPs时只推导前向传播,大部分情况默认模型后向传播的计算量是前向传播的2倍, 总共FLOPs是前向的3倍。(结论出自——https://epochai.org/blog/backward-forward-FLOP-ratio)
由于LLM模型参数过大,占用显存过多,有时候为了降低显存在训练采用将中间参数保留在内存里——激活重计算。因此推导LLM训练时FLOPs如果考虑到中间参数的激活重计算的过程,需要计算整体FLOPs需要再加一份前向计算量,即1(前向) + 2(反向)+ 1(激活重计算)= 4 倍 计算量。 (结论出自——https://arxiv.org/pdf/2205.05198.pdf)
手动推导模型的FLOPs时,优先推导整个过程计算量占大头部分,通常忽略激活函数、layer normalize,softmax等等部分计算量。
参考最简单的计算模型(LLM)FLOPs的方法
前向计算量
前置
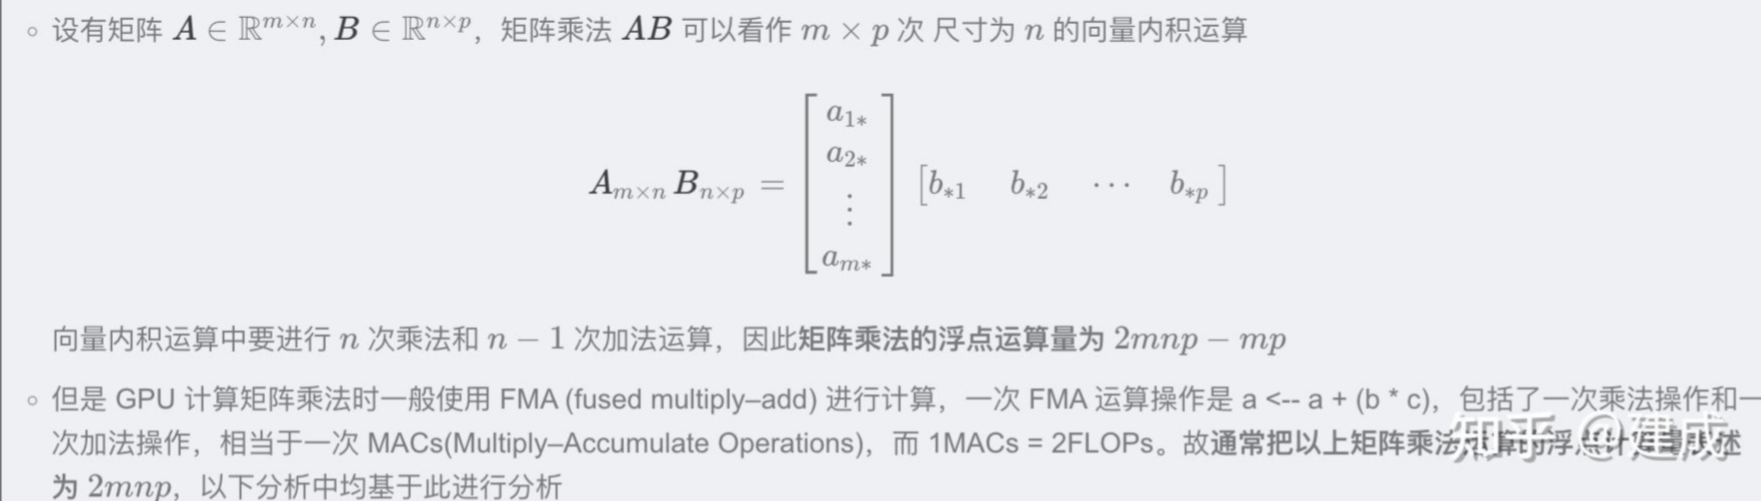
对于一般化的 [m,n]×[n,p] 矩阵,GPU 两层循环分别计算行列,因此
次行列运算,共 2mnp 次运算。
前向分成3部分
标记:
transformer 模型的层数为 l
隐藏层维度为 ℎ
注意力头数为 a
词表大小为 v
批次大小为 b
序列长度为 s
Attention
Attention 计算公式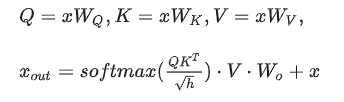
涉及 FLOPs 计算的主要是矩阵乘法,加法、乘系数、dropout 计算量较小通常忽略不计。Attention 层的矩阵乘法主要四个,分别是输入算 Q ,K ,V,QK相乘,输出四步。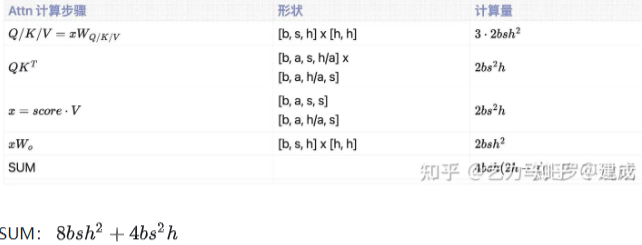
MLP
MLP 计算如下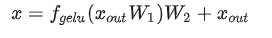
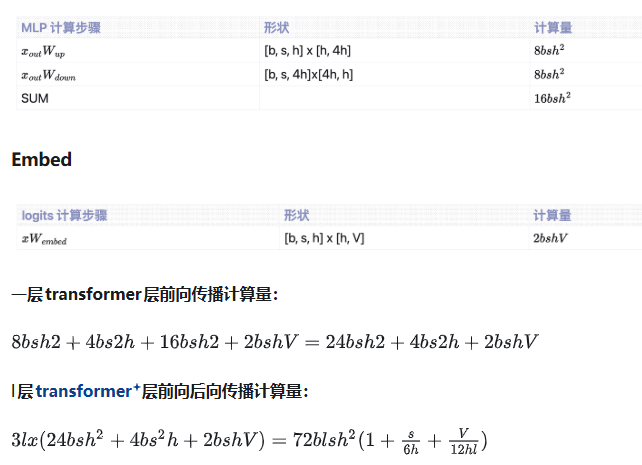
详细见 【Transformer 基础系列】手推计算量FLOPS和训练时间
理想情况计算量估算
当隐藏维度
比较大,且远大于序列长度
时,我们可以忽略一次项,计算量可以近似为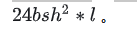
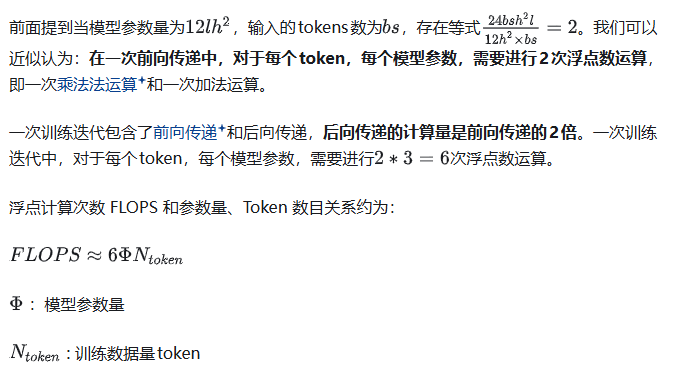
实际情况时间估算
上面说的算理想情况:即首要考虑 GPU 前后向时算矩阵运算这个时间大头,而且 h >> s,利用率100%,不考虑更新、通信、切分、其他步骤(加载数据、log等等)。
实际情况不可能达到 100%,如果考虑到上述效率,一般要打折扣。折扣系数要看框架,目前比较高效的框架算上通信加载也就0.5 模型大通常来说折扣还会高 ,因为矩阵运算占比变大了。这里
是对应 GPU 的计算能力,K是一次训练每个参数·token需要的浮点运算(K=8 如果用重计算,K=6 如果不用)。
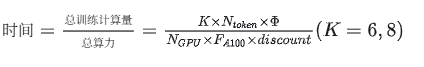
Megatron-LM中FLOPs计算
Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM https://arxiv.org/pdf/2104.04473.pdf
NVIDIA ‡Stanford University ∗Microsoft Research
附录 APPENDIX: FLOATING-POINT OPERATIONS
在本节中,我们描述了如何计算模型中的浮点运算(FLOPs)数量。我们考虑一个具有 𝑙 个Transformer层、隐藏大小 ℎ、序列长度 𝑠、词汇量 𝑉 和训练批量大小 𝐵 的语言模型。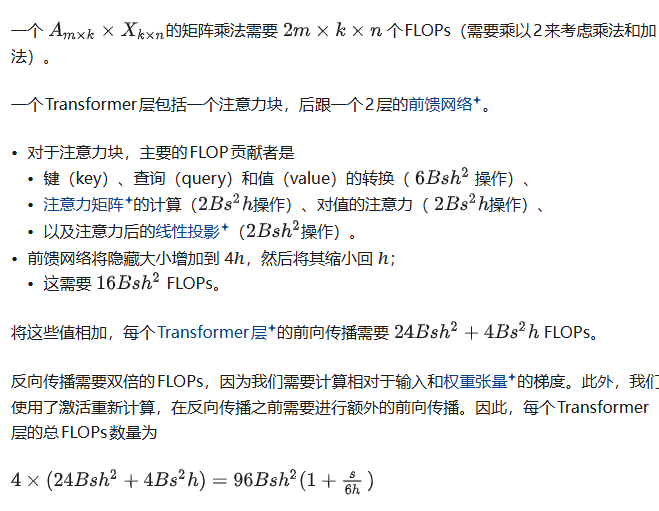
NVIDIA FLOPs计算
[论文学习]在大型 Transformer 模型中减少激活重计算
附录A FLOPs Calculation
对于FLOPs的计算,我们遵循了Narayanan等人的推导[13],只考虑了矩阵乘法(GEMMs),这是浮点运算数量的主要贡献者。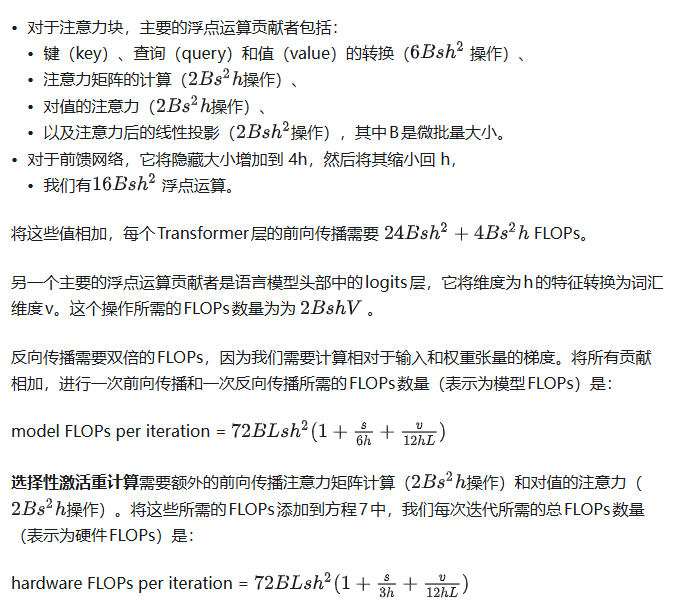
参考
Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM
[论文笔记]Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM
最简单的计算模型(LLM)FLOPs的方法
训练模型算力的单位:FLOPs、FLOPS、Macs 与 估算模型(FC, CNN, LSTM, Transformers&&LLM)的FLOPs
【Transformer 基础系列】手推计算量FLOPS和训练时间
FLOP估算脚本 https://github.com/google-research/electra/blob/master/flops_computation.py
The FLOPs Calculus of Language Model Training
“反向传播算法”过程及公式推导
昇腾大模型|分布式并行-7——模型算力利用率(MFU)+硬件算力利用率(HFU)
序列模型(3)—— LLM的参数量和计算量
评论 (0)